Ett AI-textvattenmärke är en signal som avsiktligt införs i genererad text. För en utgivare är den användbara frågan specifik: kan vi senare känna igen output från ett genereringssystem som vi själva kontrollerar?
SynthID Text svarar på den frågan. Det avgör inte huruvida en godtycklig artikel skrevs av AI. Dess detektor testar för ett konfigurerat statistiskt mönster, och ett negativt test lämnar textens ursprung oavgjort. SynthID:s referensrepository beskriver både generering och detektering av vattenmärken.
Den här guiden går igenom ett lokalt Python-exempel och undersöker sedan de svårare fallen: flera vattenmärken, omskrivning med ett nytt vattenmärke och kontroll av text när de ursprungliga nycklarna är okända.
Vad ett textvattenmärke faktiskt förändrar
En språkmodell tilldelar sannolikheter till möjliga nästa tokens. Tokens kan representera ord, delar av ord eller skiljetecken. Ett generativt vattenmärke förändrar hur nästa token väljs. De resulterande valen bär på bevis som en detektor kan mäta senare.
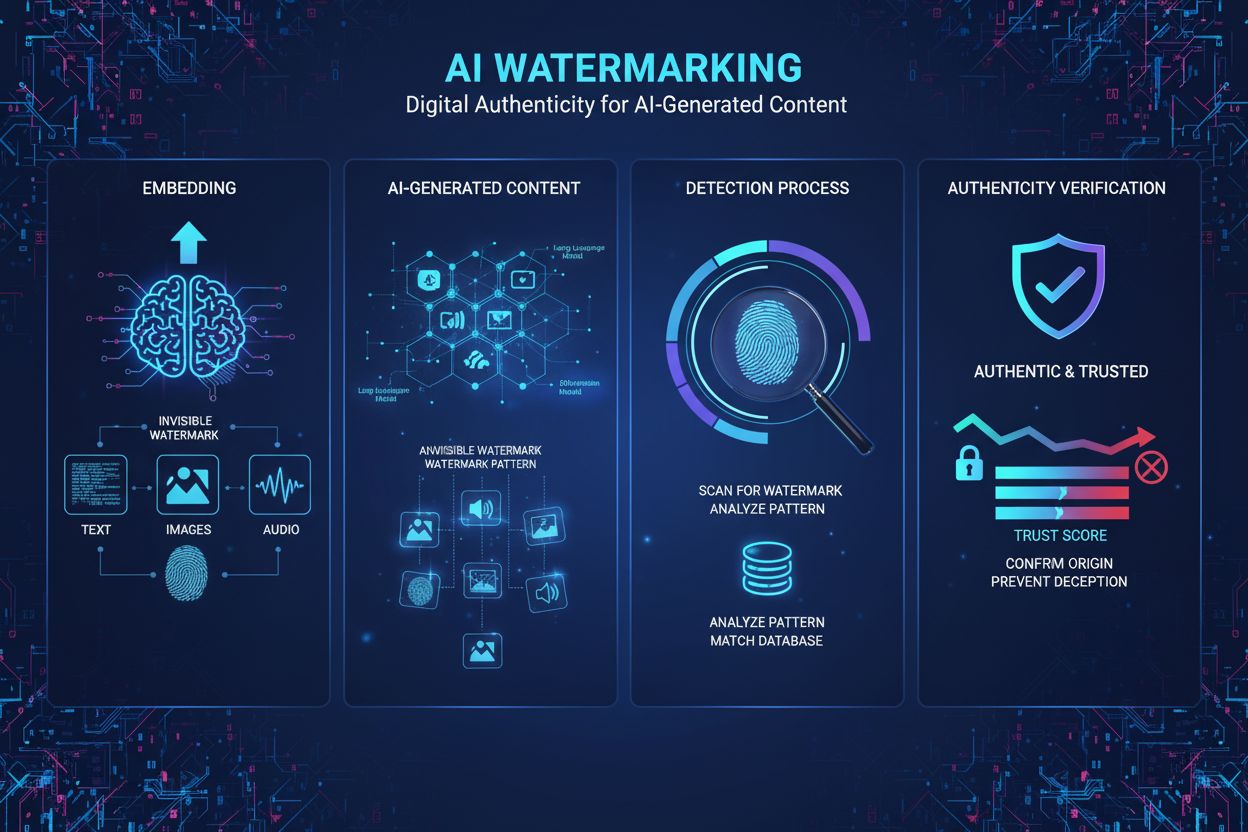
SynthID använder en process som kallas turneringssampling (tournament sampling). Kandidattokens tävlar under pseudoslumpmässiga poängfunktioner. Senaste tokenkontext och vattenmärkesnycklar avgör poängen. Genom att upprepa urvalet genom flera lager gynnas tokens med ett mätbart statistiskt mönster. Detektorn rekonstruerar dessa poäng från den färdiga texten. Den behöver inte köra den ursprungliga språkmodellen. Se SynthID:s forskningsartikel.
1. Förutsäg möjliga nästa tokens
Språkmodellen producerar en fördelning över sitt vokabulär.2. Tillämpa det konfigurerade vattenmärket
Nyckelstyrda poängfunktioner påverkar tokenvalet under genereringen.3. Publicera vanlig text
Den statistiska signalen färdas i den valda tokensekvensen.4. Rekonstruera och poängsätt
Detektorn använder kompatibel tokenisering och den matchande konfigurationen för att leta efter den signalen.Längre textpartier ger i allmänhet mer bevis. Mycket förutsägbar output lämnar färre alternativa tokens tillgängliga för vattenmärkning. Fler lager kan hjälpa, men artikeln rapporterar avtagande avkastning när lagren konsumerar den tillgängliga variationen i tokenvalet.
Statistiska vattenmärken och dolda tecken är olika saker
Innan du väljer detektor bör du identifiera vilken signal du avser att hitta.
| Metod | Vad bär signalen? | Vad bör du testa? |
|---|---|---|
| SynthID Text | Statistiska tokenval som görs under genereringen | Bevis under en matchande vattenmärkeskonfiguration |
| Markör med dolda tecken | Specifika tecken som infogats i en sträng | Teckensekvensen och dess dokumenterade kodning |
| Dokumentmetadata | Fält som kopplats till ett dokument eller en behållare | Metadatan, dess ursprung och eventuell signatur |
| AI-skrivklassificerare | Mönster inlärda från exempeltexter | Generalisering och falska positiva på den avsedda målgruppen |
En Unicode-skanner kan inte ersätta en SynthID-detektor. Att hitta ett ovanligt tecken bevisar inte heller AI-författarskap. Vår introduktion till AmICiteds gratisinstrument diskuterar teckenbaserade vattenmärkessignaler och deras begränsningar. Experimentet nedan handlar om statistisk vattenmärkning.
Generera vattenmärkt text i Python
Googles repository är en forskningsreferens och avråder uttryckligen från att använda dess modellsubklasser i produktion. Det hänvisar till implementeringen i Hugging Face Transformers. Referensen tillhandahåller också metoder för medelvärde, viktat medelvärde och tränad bayesiansk detektering. Användningsanteckningar för repositoryt
Följande exempel använder Python 3.13, Transformers 4.57.1 och PyTorch 2.8.0. Det är reproducerbara exempelversioner, inte ett påstående att de är de senaste utgåvorna. Det körs på CPU och laddar ner den publika modellen distilbert/distilgpt2 vid första användningen. Den lilla modellen håller experimentet tillgängligt; dess skrivkvalitet är inte representativ för dagens assistenter.
Skapa en isolerad miljö:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Spara Python-blocken i den här guiden, i ordning, i watermark_demo.py. Börja med genereringen:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Publika demonstrationsnycklar. Använd aldrig dessa som ett privat produktionsmärke.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Behåll fortsättningen; den angivna prompten vattenmärktes inte.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Genereringen måste exponera en kompatibel samplingspipeline. Att skicka ett färdigt svar från ett hostat API till den här konfigurationen kan inte märka det i efterhand. En separat modell skulle behöva generera en ny version.
I produktion bör du skapa unika slumpmässiga nycklar och hålla konfigurationen privat. Behåll tokenizer-revisionen, modellrevisionen, konfigurationsversionen och den associerade detektorn. En nyckelrotation skapar en ny konfiguration; behåll den gamla detekteringskonfigurationen om du fortfarande behöver känna igen äldre output. Googles implementeringsvägledning
Hur vattenmärkesdetektering beräknar bevis
Detekteringen börjar med att tokenisera kandidattexten och rekonstruera en poäng för varje giltigt tokenfönster och vattenmärkeslager. I den implementering som används här kallas dessa binära poäng för g-värden. Vi beräknar medelvärdet av dem efter att ha uteslutit upprepade kontexter och positioner vid eller efter sekvensslutstoken. De första fyra tokens i en fortsättning bildar inte ett fullständigt fönster på fem tokens på egen hand.
Följande funktion använder Transformers metoder för poängsättning och maskning. Den tar emot en icke-paddad sekvens i taget och returnerar ett råmedelvärde, inte en sannolikhet för författarskap.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolesk indexering behåller lagerdimensionen.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Kontrollen med direkta token-ID isolerar genereringen från textserialiseringen. Den andra kontrollen prövar den väg en detektor ser efter publicering. Utvärdera din faktiska publicerings- och textextraheringspipeline, eftersom den kan förändra indata.
En poäng på 0.60 betyder inte att sannolikheten är 60 % att AI skrev texten. Den här funktionen har ingen kalibrerad beslutströskel. Ett kort textparti kan få hög poäng av en slump. Rapportera ett icke-slutgiltigt resultat när bevisen är otillräckliga.
För en användbar detektor bör du samla in representativ mänsklig text, ovattenmärkt modelloutput och vattenmärkt output. Håll kalibreringsdata separat från den slutliga utvärderingsdatan. Välj en tröskel för en acceptabel andel falska positiva, utvärdera detekteringsfrekvenser på hållna stickprov och dela upp resultaten efter språk, längd och innehållstyp. Ett enda märkt/omärkt par kontrollerar bara att exemplet körs.
Som ett tränat alternativ tillhandahåller Hugging Face en bayesiansk detektor och ett arbetsflöde för detektorträning. En detektor som tränats för orelaterade nycklar är ingen direkt ersättning för din detektor. En slumpmässigt initierad checkpoint eller demonstrationscheckpoint fastställer inte detekteringsnoggrannhet.

Håll dig uppdaterad om trender inom AI-synlighet
Få de senaste insikterna om AI-omnämnanden, varumärkesövervakning och optimeringsstrategier.
Kan du detektera NÅGOT SynthID-vattenmärke utan dess nycklar?
Den publicerade detekteringsmetoden kräver en matchande konfiguration. Du behöver också kompatibel tokenisering. Att veta att en leverantör använder SynthID-algoritmen ger dig inte dess konfiguration, och det publika repositoryt är inte en detektor för varje leverantörs output.
Google beskriver privata detektorer, detektorer som exponeras via ett API och publikt distribuerade detektorer. En leverantör skulle kunna erbjuda verifiering utan att avslöja sin privata konfiguration. Detektering och verifierbarhet
För vårt eget system kan vi kontrollera ett register över kända konfigurationer. Lägg till det här exemplet för att jämföra de korrekta nycklarna med orelaterade demonstrationsnycklar:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Kör den sammansatta filen med python watermark_demo.py. Den här jämförelsen ger bevis för två kända konfigurationer. Den kan inte upptäcka en godtycklig okänd nyckel, och den märker avsiktligt inte någon av poängerna som en detektering.
Att kontrollera många konfigurationer innebär också att utföra många statistiska tester. Om varje test tillåter falska positiva kan acceptansen av vilket positivt resultat som helst öka den totala andelen falska positiva. Kalibrera hela sökproceduren. Där enskilda tester ger giltiga p-värden är ett konservativt alternativ att dividera den totala tillåtna mängden falska positiva med antalet tester. Använd inte den aritmetiken direkt på råpoängen mean_g.
Om ingen känd konfiguration matchar är det lämpliga resultatet “Inget vattenmärke som stöds hittades.” Möjligheterna omfattar fortfarande mänskligt skrivande, ovattenmärkt AI-output, ett okänt vattenmärke och ett redigerat textparti vars signal är för svag.
Kan samma text bära flera SynthID-vattenmärken?
Det finns två olika konstruktioner att överväga.
Flera lager i en konfiguration
SynthID stöder redan en lista med nycklar. I exemplet skapar 30 nycklar 30 lager inom ett konfigurerat vattenmärke. Detektorn kombinerar deras bevis. Dessa nycklar representerar inte automatiskt 30 separat tillskrivbara författare eller organisationer. Konfiguration av vattenmärke
Oberoende detekterbara plattforms- och kundmärken
Anta att du vill att en plattformsövergripande detektor och en separat kundspecifik detektor ska känna igen samma textparti. Att tilldela grupper av lager för dessa syften är ett experimentellt designalternativ, inte en dokumenterad garanti från biblioteket.
Att bara sammanfoga två nyckellistor visar inte att båda de ursprungliga detektorerna fortfarande fungerar. Varje detektor skulle behöva utvärderas på den kombinerade genereringsprocessen, inklusive sin position i lagersekvensen. Mät varje märkes detekteringsfrekvens, korsvisa matchningar mot andra kunder och beteendet efter redigeringar. Detta är ett ingenjörsförslag som kräver experiment, snarare än ett påstående att SynthID tillhandahåller oberoende tillskrivning till flera ägare direkt ur lådan.
Om en central tjänst bara behöver identifiera en kund är en enklare konstruktion en konfiguration per kund med ett internt register. Den konstruktionen behöver fortfarande kalibreras över hela registret. Den ger inte ett separat plattformsövergripande märke som kan kontrolleras utan att söka igenom kundkonfigurationer.
Kan du ersätta ett befintligt vattenmärke?
SynthID lagrar inte något fält som watermark_id i texten. Det finns inget metadatavärde att skriva över. Den ursprungliga signalen är fördelad över tokenvalen.
Om du skriver om ett textparti med en andra vattenmärkt generator inför den nya genereringsprocessen sin egen signal. Effekten på den tidigare signalen beror på den resulterande tokensekvensen. Google rapporterar att milda redigeringar kan bevara detekterbarheten, medan genomgripande omskrivning eller översättning kan minska konfidensen avsevärt. Dokumenterade gränser för transformering
Det följer att ett andra vattenmärke inte garanterar att det första raderas. Båda signalerna kan förbli detekterbara, eller en eller båda kan falla under sina detekteringströsklar. Detta är en slutsats om ett kombinerat arbetsflöde; den citerade dokumentationen fastställer inte en överlevnadsfrekvens för varje par av vattenmärken.
En okänd första konfiguration skapar en praktisk gräns. Vår egen detektor kan utvärdera vårt märke, men den kan inte fastställa att det ursprungliga märket försvann. Det kräver tillgång till den ursprungliga matchande detektorn. Även ett negativt resultat betyder att detektorn inte hittade tillräckliga bevis under sina inställningar, inte ett bevis för att varje spår avlägsnats.
Hur du testar överlappande vattenmärken
Innan du hävdar att märken samexisterar eller att det ena ersätter det andra bör du använda en testmatris. Posterna nedan beskriver experiment att utföra, inte uppmätta resultat.
| Urvalsgrupp | Detektor A | Detektor B | Vad jämförelsen kontrollerar |
|---|---|---|---|
| Mänsklig text och ovattenmärkt AI-text | Kör | Kör | Baslinje för falska positiva |
| Text genererad med endast A | Kör | Kör | Detektering av A och oavsiktliga B-matchningar |
| Text genererad med endast B | Kör | Kör | Detektering av B och oavsiktliga A-matchningar |
| Text genererad med en experimentell kombinerad konfiguration | Kör | Kör | Huruvida varje avsett märke är detekterbart |
| En text omskriven under B | Kör | Kör | A:s överlevnad och B:s detektering efter omskrivning |
| Korta utdrag och redigerade versioner av varje grupp | Kör | Kör | Känslighet för publiceringsarbetsflödet |
Använd hållna prompter och rapportera användbara textlängder, antal stickprov, detektorversioner, trösklar och andelar falska positiva. Inkludera osäkerhet kring de rapporterade andelarna. Upprepa utvärderingen när du ändrar nycklar, tokenisering, modellversioner eller genereringsinställningar. Fram till dess att dessa kontroller finns bör samexistens och ersättning beskrivas som overifierade.
Vad detta innebär för utgivare och AI-synlighet
Vattenmärkesdetektering och AI-citeringsövervakning besvarar olika frågor. Ett vattenmärkestest frågar huruvida ett textparti bär bevis för en viss genereringskonfiguration. Citeringsövervakning kontrollerar vilka källor som förekommer i AI-svar.
Presentera inte ett saknat vattenmärke som bevis för mänskligt författarskap, eller ett detekterat vattenmärke som bevis för att en viss webbplats citerades. För publiceringsarbetsflöden bör du behålla generationsloggar och redaktionell tillskrivning vid sidan av varje statistisk detektor. Var och en ger bevis som de andra inte ger.
 LinkedIn