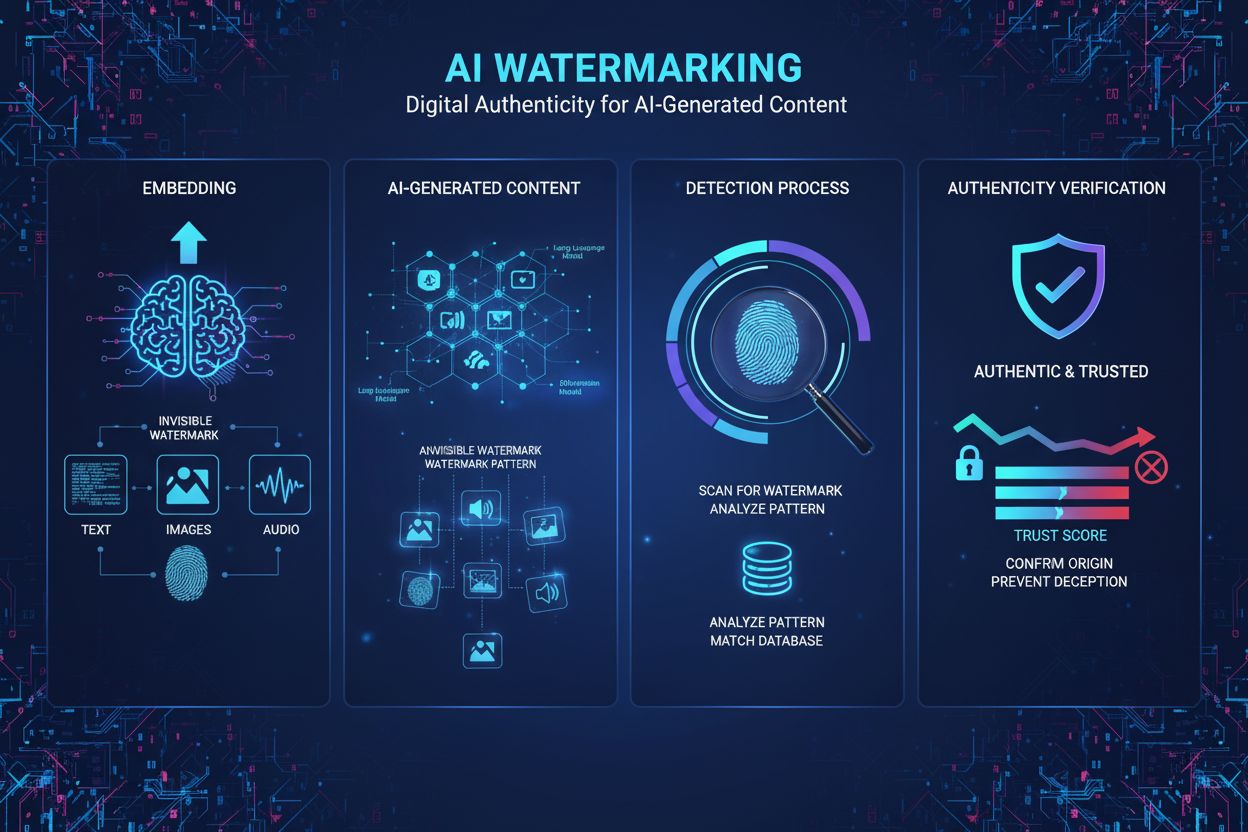
Een AI-tekstwatermerk is een signaal dat bewust in gegenereerde tekst wordt aangebracht. Voor een uitgever is de nuttige vraag heel specifiek: kunnen we later output herkennen van een generatiesysteem dat wij zelf beheren?
SynthID Text beantwoordt die vraag. Het bepaalt niet of een willekeurig artikel door AI is geschreven. De detector test op een geconfigureerd statistisch patroon, en een mislukte test laat de herkomst van de tekst onopgelost. De SynthID-referentierepository beschrijft zowel het genereren als het detecteren van watermerken.
Deze gids loopt door een lokaal Python-voorbeeld en bekijkt daarna de moeilijkere gevallen: meerdere watermerken, herschrijven met een nieuw watermerk, en het controleren van tekst wanneer de oorspronkelijke sleutels onbekend zijn.
Wat een tekstwatermerk feitelijk verandert
Een taalmodel kent waarschijnlijkheden toe aan mogelijke volgende tokens. Tokens kunnen woorden, delen van woorden of leestekens vertegenwoordigen. Een generatief watermerk verandert hoe het volgende token wordt gekozen. De resulterende keuzes dragen bewijs dat een detector later kan meten.
SynthID gebruikt een proces dat tournament sampling heet. Kandidaat-tokens concurreren onder pseudorandom scorefuncties. De recente tokencontext en de watermerksleutels bepalen de scores. Door de selectie in meerdere lagen te herhalen, krijgen tokens met een meetbaar statistisch patroon de voorkeur. De detector reconstrueert deze scores uit de voltooide tekst. Hij hoeft het oorspronkelijke taalmodel niet te draaien. Zie het SynthID-onderzoekspaper.
1. Voorspel mogelijke volgende tokens
Het taalmodel produceert een verdeling over zijn vocabulaire.2. Pas het geconfigureerde watermerk toe
Scorefuncties met sleutels beïnvloeden de tokenselectie tijdens de generatie.3. Publiceer gewone tekst
Het statistische signaal reist mee in de gekozen tokensequentie.4. Reconstrueer en scoor
De detector gebruikt compatibele tokenisatie en de bijbehorende configuratie om dat signaal te vinden.Langere passages leveren over het algemeen meer bewijs. Zeer voorspelbare output laat minder alternatieve tokens over om te watermerken. Meer lagen kunnen helpen, maar het paper meldt afnemende meeropbrengsten naarmate lagen de beschikbare variatie in tokenselectie opsouperen.
Statistische watermerken en verborgen tekens zijn verschillend
Bepaal voordat je een detector kiest welk signaal je wilt vinden.
| Methode | Wat draagt het signaal? | Wat moet je testen? |
|---|---|---|
| SynthID Text | Statistische tokenkeuzes die tijdens de generatie zijn gemaakt | Bewijs onder een bijbehorende watermerkconfiguratie |
| Markering met verborgen tekens | Specifieke tekens die in een string zijn ingevoegd | De tekenreeks en de gedocumenteerde codering ervan |
| Documentmetadata | Velden die aan een document of container zijn gekoppeld | De metadata, de herkomst en een eventuele handtekening |
| AI-schrijfclassificator | Patronen die uit voorbeeldteksten zijn geleerd | Generalisatie en fout-positieven bij het beoogde publiek |
Een Unicode-scanner kan geen SynthID-detector vervangen. Het vinden van een ongewoon teken bewijst ook geen AI-auteurschap. Onze introductie tot de gratis tools van AmICited bespreekt watermerksignalen op basis van tekens en hun beperkingen. Het experiment hieronder gaat over statistische watermerken.

Klaar om je AI-zichtbaarheid te monitoren?
Volg hoe AI-chatbots je merk noemen in ChatGPT, Perplexity en andere platforms.
Genereer gewatermerkte tekst in Python
De Google-repository is een onderzoeksreferentie en adviseert expliciet om de modelsubklassen ervan niet in productie te gebruiken. Ze verwijst naar de implementatie in Hugging Face Transformers. De referentie biedt ook mean-, weighted-mean- en getrainde Bayesiaanse detectiemethoden. Gebruiksnotities bij de repository
Het volgende voorbeeld gebruikt Python 3.13, Transformers 4.57.1 en PyTorch 2.8.0. Dit zijn reproduceerbare voorbeeldversies, geen claim dat dit de nieuwste releases zijn. Het draait op CPU en downloadt bij het eerste gebruik het openbare model distilbert/distilgpt2. Dat kleine model houdt het experiment toegankelijk; de schrijfkwaliteit ervan is niet representatief voor huidige assistenten.
Maak een geïsoleerde omgeving aan:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Sla de Python-blokken in deze gids, in volgorde, op in watermark_demo.py. Begin met generatie:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Openbare demonstratiesleutels. Gebruik deze nooit als privéproductiemarkering.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Behoud het vervolg; de meegegeven prompt was niet gewatermerkt.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Generatie moet een compatibele sampling-pijplijn beschikbaar stellen. Een voltooid antwoord van een gehoste API door deze configuratie halen, kan het niet achteraf nog markeren. Een afzonderlijk model zou een nieuwe versie moeten genereren.
Maak in productie unieke willekeurige sleutels aan en houd de configuratie privé. Bewaar de tokenizer-revisie, modelrevisie, configuratieversie en de bijbehorende detector. Een sleutelrotatie creëert een nieuwe configuratie; bewaar de oude detectieconfiguratie als je oudere output nog moet herkennen. Implementatierichtlijnen van Google
Hoe watermerkdetectie bewijs berekent
Detectie begint met het tokeniseren van de kandidaattekst en het reconstrueren van een score voor elk in aanmerking komend tokenvenster en elke watermerklaag. In de hier gebruikte implementatie heten deze binaire scores g-waarden. We middelen ze nadat we herhaalde contexten en posities op of na het end-of-sequence-token hebben uitgesloten. De eerste vier tokens van een vervolg vormen op zichzelf geen volledig venster van vijf tokens.
De volgende functie gebruikt de scoring- en maskeringsmethoden van Transformers. Ze accepteert één niet-opgevulde sequentie per keer en retourneert een ruw gemiddelde, geen auteurschapswaarschijnlijkheid.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Booleaanse indexering behoudt de laagdimensie.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
De directe controle op token-ID’s isoleert de generatie van de tekstserialisatie. De tweede controle doorloopt het pad dat een detector na publicatie ziet. Evalueer je eigen publicatie- en tekstextractiepijplijn, want die kan de invoer veranderen.
Een score van 0,60 betekent niet dat er 60% kans is dat AI de tekst heeft geschreven. Deze functie heeft geen gekalibreerde beslissingsdrempel. Een korte passage kan bij toeval hoog scoren. Rapporteer een onbeslist resultaat wanneer het bewijs onvoldoende is.
Verzamel voor een bruikbare detector representatieve menselijke tekst, niet-gewatermerkte modeloutput en gewatermerkte output. Houd kalibratiedata gescheiden van de definitieve evaluatiedata. Kies een drempel voor een acceptabel fout-positiefpercentage, evalueer detectiepercentages op achtergehouden samples en splits de resultaten uit naar taal, lengte en contenttype. Een enkel paar gemarkeerd/ongemarkeerd controleert alleen of het voorbeeld werkt.
Voor een getraind alternatief levert Hugging Face een Bayesiaanse detector en een workflow voor het trainen van een detector. Een detector die voor niet-verwante sleutels is getraind, is geen directe vervanging van jouw detector. Een willekeurig geïnitialiseerd checkpoint of demonstratie-checkpoint bewijst geen detectienauwkeurigheid.
Blijf op de hoogte van trends in AI-zichtbaarheid
Ontvang de nieuwste inzichten over AI-vermeldingen, merkmonitoring en optimalisatiestrategieën.
Kun je ELK SynthID-watermerk detecteren zonder de sleutels?
De gepubliceerde detectiemethode vereist een bijbehorende configuratie. Je hebt ook compatibele tokenisatie nodig. Weten dat een aanbieder het SynthID-algoritme gebruikt, geeft je nog niet de configuratie, en de openbare repository is geen detector voor de output van elke aanbieder.
Google beschrijft privédetectoren, detectoren die via een API beschikbaar zijn en openbaar gedistribueerde detectoren. Een aanbieder zou verificatie kunnen bieden zonder de privéconfiguratie prijs te geven. Detectie en verifieerbaarheid
Voor ons eigen systeem kunnen we een register van bekende configuraties controleren. Voeg dit voorbeeld toe om de juiste sleutels te vergelijken met niet-verwante demonstratiesleutels:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Voer het samengestelde bestand uit met python watermark_demo.py. Deze vergelijking levert bewijs voor twee bekende configuraties. Ze kan geen willekeurige onbekende sleutel vinden en labelt bewust geen van beide scores als een detectie.
Veel configuraties controleren betekent ook veel statistische tests uitvoeren. Als elke test fout-positieven toestaat, kan het accepteren van elke positieve uitslag het totale fout-positiefpercentage verhogen. Kalibreer de volledige zoekprocedure. Waar individuele tests geldige p-waarden opleveren, is een conservatieve optie om de totale toegestane fout-positiefmarge te delen door het aantal tests. Pas die rekensom niet rechtstreeks toe op de ruwe mean_g-score.
Als geen enkele bekende configuratie overeenkomt, is het juiste resultaat ‘Geen ondersteund watermerk gedetecteerd.’ De mogelijkheden omvatten nog steeds menselijk schrijfwerk, niet-gewatermerkte AI-output, een onbekend watermerk en een bewerkte passage waarvan het signaal te zwak is.
Kan dezelfde tekst meerdere SynthID-watermerken bevatten?
Er zijn twee verschillende ontwerpen om te overwegen.
Meerdere lagen in één configuratie
SynthID ondersteunt al een lijst met sleutels. In het voorbeeld creëren 30 sleutels 30 lagen binnen één geconfigureerd watermerk. De detector combineert hun bewijs. Die sleutels vertegenwoordigen niet automatisch 30 afzonderlijk toerekenbare auteurs of organisaties. Watermerkconfiguratie
Onafhankelijk detecteerbare platform- en klantmarkeringen
Stel dat je een platformsbrede detector en een aparte klantspecifieke detector wilt die dezelfde passage herkennen. Groepen lagen aan die doelen toewijzen is een experimentele ontwerpoptie, geen gedocumenteerde garantie van de bibliotheek.
Het simpelweg samenvoegen van twee sleutellijsten bewijst niet dat beide oorspronkelijke detectoren nog werken. Elke detector zou moeten worden geëvalueerd op het gecombineerde generatieproces, inclusief de positie ervan in de laagvolgorde. Meet het detectiepercentage van elke markering, kruisovereenkomsten met andere klanten en het gedrag na bewerkingen. Dit is een technisch voorstel dat experimenten vereist, geen claim dat SynthID out of the box onafhankelijke toewijzing aan meerdere eigenaren biedt.
Als een centrale dienst alleen een klant hoeft te identificeren, is een eenvoudiger ontwerp één configuratie per klant met een intern register. Dat ontwerp vereist nog steeds kalibratie over het volledige register. Het biedt geen aparte platformsbrede markering die kan worden gecontroleerd zonder klantconfiguraties te doorzoeken.
Kun je een bestaand watermerk vervangen?
SynthID slaat geen veld zoals watermark_id op in de tekst. Er is geen metadatawaarde om te overschrijven. Het oorspronkelijke signaal is verdeeld over de tokenkeuzes.
Als je een passage herschrijft met een tweede gewatermerkte generator, introduceert het nieuwe generatieproces zijn eigen signaal. Het effect op het eerdere signaal hangt af van de resulterende tokensequentie. Google meldt dat milde bewerkingen de detecteerbaarheid kunnen behouden, terwijl grondig herschrijven of vertalen het vertrouwen aanzienlijk kan verlagen. Gedocumenteerde transformatielimieten
Hieruit volgt dat een tweede watermerk niet garandeert dat het eerste wordt uitgewist. Beide signalen kunnen detecteerbaar blijven, of een van beide of beide kunnen onder hun detectiedrempels zakken. Dit is een gevolgtrekking over een gecombineerde workflow; de aangehaalde documentatie stelt geen overlevingspercentage vast voor elk paar watermerken.
Een onbekende eerste configuratie zorgt voor een praktische beperking. Onze eigen detector kan ons watermerk evalueren, maar kan niet vaststellen dat het oorspronkelijke watermerk is verdwenen. Dat vereist toegang tot de oorspronkelijke bijbehorende detector. Zelfs een negatief resultaat betekent dat de detector onder zijn instellingen niet genoeg bewijs vond, niet dat elk spoor is verwijderd.
Hoe je overlappende watermerken test
Gebruik een testmatrix voordat je beweert dat markeringen naast elkaar bestaan of dat de ene de andere vervangt. De onderstaande regels beschrijven experimenten die je moet uitvoeren, niet gemeten uitkomsten.
| Samplegroep | Detector A | Detector B | Wat de vergelijking controleert |
|---|---|---|---|
| Menselijke en niet-gewatermerkte AI-tekst | Uitvoeren | Uitvoeren | Baseline fout-positieven |
| Tekst gegenereerd met alleen A | Uitvoeren | Uitvoeren | Detectie van A en toevallige overeenkomsten met B |
| Tekst gegenereerd met alleen B | Uitvoeren | Uitvoeren | Detectie van B en toevallige overeenkomsten met A |
| Tekst gegenereerd met een experimentele gecombineerde configuratie | Uitvoeren | Uitvoeren | Of elke bedoelde markering detecteerbaar is |
| Een tekst die onder B opnieuw is geschreven | Uitvoeren | Uitvoeren | Overleving van A en detectie van B na het herschrijven |
| Korte fragmenten en bewerkte versies van elke groep | Uitvoeren | Uitvoeren | Gevoeligheid voor de publicatieworkflow |
Gebruik achtergehouden prompts en rapporteer bruikbare tekstlengtes, aantallen samples, detectorversies, drempels en fout-positiefpercentages. Vermeld de onzekerheid rond de gerapporteerde percentages. Herhaal de evaluatie wanneer je sleutels, tokenisatie, modelversies of generatie-instellingen wijzigt. Beschrijf naastbestaan en vervanging als niet-geverifieerd totdat die controles bestaan.
Wat dit betekent voor uitgevers en AI-zichtbaarheid
Watermerkdetectie en AI-citatiemonitoring beantwoorden verschillende vragen. Een watermerktest vraagt of een passage bewijs draagt van een bepaalde generatieconfiguratie. Citatiemonitoring controleert welke bronnen in AI-antwoorden voorkomen.
Presenteer een ontbrekend watermerk niet als bewijs van menselijk auteurschap, of een gedetecteerd watermerk niet als bewijs dat een bepaalde website is geciteerd. Houd voor publicatieworkflows generatieregisters en redactionele toeschrijving naast een eventuele statistische detector. Elk levert bewijs dat de andere niet leveren.
 LinkedIn